 Tech-Connect Actualités tech, tutoriels et astuces informatiques expliqués simplement
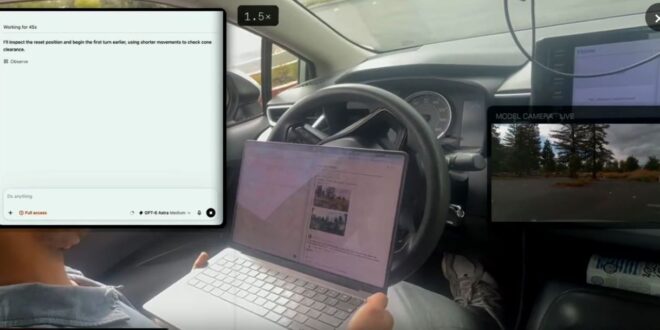
Un parking presque désert de la baie de San Francisco, quelques dizaines de petits cônes multicolores posés au sol, une Toyota Corolla grise tout ce qu’il y a de plus banal. Sur le siège conducteur, un humain les mains posées sur les genoux, le pied suspendu au-dessus de la pédale de frein. Et à côté, sur un ordinateur portable, une fenêtre de discussion. C’est elle qui conduit.
Pas un logiciel de conduite autonome entraîné pendant des millions de kilomètres comme ceux de Waymo ou de Tesla. Non : un assistant conversationnel généraliste, le même genre d’IA à qui vous demandez de résumer un courriel ou de corriger un code. L’expérience s’appelle DrivingBench, et son verdict tient en une ligne : sur quatre modèles parmi les plus avancés du marché, un seul, GPT-6 Astra d’OpenAI, a bouclé le parcours.
Derrière le côté spectaculaire (et un peu cocasse) de l’affaire se cache une vraie question, beaucoup plus sérieuse qu’il n’y paraît : une IA qui sait parler du monde sait-elle aussi agir dedans ? Décortiquons ensemble ce test, ses résultats, ses coulisses étonnantes… et ce qu’il dit vraiment de l’avenir.
DrivingBench, c’est quoi exactement ?
Dans le jargon de l’intelligence artificielle, un benchmark est un banc d’essai : une épreuve standardisée qui permet de comparer plusieurs modèles dans les mêmes conditions, un peu comme un examen commun passé par tous les élèves d’une classe. Il en existe des centaines pour les mathématiques, la programmation, la culture générale… Presque tous ont un point commun : ils se déroulent entièrement sur écran.
DrivingBench rompt avec cette habitude. Ses trois concepteurs, Aditya Ramabadran, Simon Mahns et Tobias Gessler, se présentent comme l’auteur du premier banc d’essai où des modèles généralistes « vision-langage » doivent piloter une voiture réelle. Le code, les instructions (prompts) et les vidéos de chaque tentative ont été publiés en accès libre sur drivingbench.com et sur GitHub.
| 🔵 Pour les non-initiés : un modèle « vision-langage », c’est quoi ? Un grand modèle de langage (LLM) est une IA entraînée sur d’immenses quantités de texte pour comprendre et produire du langage : ChatGPT, Claude ou Grok en sont des exemples. Un modèle vision-langage (VLM) va un cran plus loin : il sait aussi « regarder » des images. On peut lui montrer une photo et lui demander ce qu’il y voit. Point crucial : aucun des modèles testés n’a été entraîné pour conduire. Ils découvrent la tâche sur le moment, à partir d’images et de quelques consignes écrites. C’est toute la saveur, et toute la difficulté, de l’expérience. |
Comment une IA de discussion peut-elle tenir un volant ?
Rassurez-vous, aucun robot humanoïde ne s’est assis derrière le volant. Le montage repose sur une astuce élégante, que l’on peut décomposer en trois étages.
1. Le « traducteur » matériel : le boîtier comma four
La Corolla de 2022 a été équipée d’un comma four, un petit boîtier de la société comma.ai qui se fixe derrière le pare-brise. Il fait tourner openpilot, un logiciel open source d’aide à la conduite. Surtout, il se branche sur le bus CAN de la voiture, le réseau interne par lequel les calculateurs du véhicule échangent leurs ordres. C’est par ce canal que l’on peut commander la direction, l’accélération et le freinage.
| 🔵 Le bus CAN, en une image Pensez au bus CAN comme au système nerveux de votre voiture. Quand vous tournez le volant d’une voiture moderne équipée de direction assistée électrique, ce n’est plus seulement une tige métallique qui agit : des messages numériques circulent entre capteurs et moteurs. Le comma four « parle » ce langage. Il peut donc envoyer à la voiture des messages du type « tourne de 30 % » ou « ralentis », exactement comme le ferait le régulateur de vitesse adaptatif d’usine. |
2. La passerelle logicielle : trois « outils » et un serveur MCP
Entre le boîtier et l’IA, les ingénieurs ont construit une couche logicielle exposée via le MCP (Model Context Protocol), un standard qui permet à un assistant IA d’utiliser des outils extérieurs. Concrètement, le modèle ne dispose que de trois commandes :
- observe() : regarder. L’IA reçoit les images des caméras ainsi que la vitesse, l’angle du volant et le temps restant sur l’ordre en cours.
- set_motion() : bouger. L’IA indique une direction, un pourcentage de braquage, une vitesse, une durée… et doit même justifier son choix en une courte phrase.
- stop_now() : piler. Un freinage immédiat.
Petit détail qui change tout : la voiture continue de rouler pendant que l’IA réfléchit. Chaque nouvel ordre remplace le précédent, et quand un ordre expire, la voiture freine. L’IA doit donc anticiper son propre temps de réflexion, un peu comme un conducteur débutant qui apprend qu’on ne regarde pas son GPS pendant dix secondes en plein virage.
3. Le cerveau : l’assistant dans son environnement habituel
Chaque modèle tournait dans son « harnais » d’agent natif, avec un niveau de réflexion moyen : GPT-6 Astra et GPT-5.6 Sol dans Codex, Claude Fable 5.1 dans Claude Code, Grok 4.6 dans Cursor. Le tout piloté depuis un ordinateur portable relié à Internet par réseau mobile.
Le parcours et les garde-fous
Le circuit, d’environ 134,7 mètres, serpente dans un grand parking : un virage à gauche pour entrer, une longue allée droite, quelques courbes douces, deux virages à droite, puis une approche finale vers une zone d’arrivée balisée de cônes bleus où il faut se garer. Les concepteurs ont volontairement évité les virages trop serrés pour le couple Corolla + comma, et avouent avoir été surpris qu’un modèle aille au bout.
Côté sécurité, rien n’a été laissé au hasard :
- Vitesse plafonnée à 3,5 m/s (environ 12,6 km/h), avec un arrêt d’urgence automatique au-delà de 6 m/s.
- Volant limité à 100 degrés de rotation par seconde.
- Un humain au volant en permanence, pied au-dessus du frein, prêt à reprendre la main.
- La surveillance du conducteur d’openpilot et ses autres protections ont été conservées.
| 🔴 Nuance importante Il ne s’agit en aucun cas d’une conduite sur route ouverte. Parking vide, vitesse d’escargot, superviseur humain : ce test mesure une capacité de base, pas une aptitude à circuler en ville. Les auteurs eux-mêmes préviennent que leur logiciel de recherche s’utilise à vos risques, et précisent n’avoir aucun lien avec Toyota, comma.ai ni les éditeurs des modèles testés. |
Les résultats : un vainqueur, trois naufragés
Chaque modèle disposait de jusqu’à trois tentatives dans une même conversation. Après un échec, l’opérateur envoyait un message générique invitant l’IA à analyser ce qui avait cloché avant de réessayer. Le score correspond à la progression le long de la ligne médiane du parcours, comptée seulement tant que la voiture reste à moins de 4 mètres de cette ligne.
| Modèle | Essai 1 | Essai 2 | Essai 3 | Meilleur score |
| GPT-6 Astra (OpenAI) | 49 % | 100 % (5 min 22) | — | ✅ 100 % |
| Claude Fable 5.1 (Anthropic) | 9 % | 10 % | 45 % | 45 % |
| Grok 4.6 (xAI) | 8 % | 11 % | 10 % | 11 % |
| GPT-5.6 Sol (OpenAI) | 6 % | 6 % | 6 % | 6 % |
GPT-6 Astra : la tortue qui a gagné la course
Lors de son premier essai, Astra parcourt environ 67 mètres avant de sortir du tracé. Dans son analyse, il reconnaît avoir cru la voiture alignée trop tôt et décide d’avancer par petits incréments, plus lentement, près des courbes. Résultat : au second essai, il ne dépasse jamais 0,8 m/s, braque à fond sur 20 de ses 24 commandes… et termine les 134,7 mètres en 5 minutes et 22 secondes, avant de se garer dans la zone bleue.
Faites le calcul : cela donne une moyenne d’environ 0,42 m/s, soit 1,5 km/h. Un piéton qui flâne va trois fois plus vite. Mais il est arrivé. Astra interrogeait ses caméras toutes les 5 à 6 secondes et envoyait environ six ordres par minute, un rythme qui lui a permis d’enchaîner les commandes sans « trou ».
Claude Fable 5.1 : le progrès le plus net, mais pas suffisant
Le modèle d’Anthropic est passé de 9 % à 10 %, puis à 45 % au troisième essai, la meilleure courbe d’apprentissage après Astra. Sa stratégie a évolué en sens inverse : parti avec des braquages de 60 à 100 %, il a jugé que c’était trop et s’est fixé une valeur par défaut de 30 %. Au dernier essai, il a bien identifié la voie dans la longue ligne droite, mais n’a pas laissé assez de marge pour le virage à droite suivant.
Son talon d’Achille ? La lenteur de décision. Lors de sa deuxième tentative, la voiture n’a roulé que 31 secondes sur environ 190 : le reste du temps, elle attendait, freinée, que le modèle finisse de réfléchir.
Grok 4.6 et GPT-5.6 Sol : bloqués au premier virage
Ni l’un ni l’autre n’ont réellement dépassé le premier virage. Grok a pourtant bien diagnostiqué son problème, il s’est lui-même conseillé de faire se chevaucher ses commandes, mais a continué à laisser des blancs d’une dizaine de secondes à l’essai suivant. Quant à GPT-5.6 Sol, prédécesseur d’Astra, il a plafonné à 6 % à chacune de ses trois tentatives.
Pourquoi les IA ont-elles échoué ? Trois coupables
1. La perception : lire une rangée de cônes, c’est dur
La plupart des tentatives se sont arrêtées au premier virage, là où une ligne de cônes en diagonale délimite la voie. Il fallait comprendre de quel côté de cette ligne se trouvait la route. Pour un humain, c’est instantané. Pour une IA qui ne voit le monde qu’à travers quelques images figées, c’est une énigme.
Les « autocritiques » des modèles sont savoureuses. Claude a admis avoir encore choisi le mauvais côté de la limite. GPT-5.6 Sol a compris qu’il avait cru, à tort, que la couleur des cônes indiquait le côté de la voie alors que les concepteurs les avaient justement mélangés exprès. Grok, lui, a noté que la voiture est plus large qu’elle n’en a l’air sur la caméra. Un constat que bien des apprentis conducteurs connaissent au moment du créneau.
2. La latence : penser trop longtemps, c’est rouler à l’aveugle
Dans un test classique, une IA peut réfléchir une minute sans conséquence. Ici, chaque seconde de réflexion est une seconde où la voiture roule ou attend. Les concepteurs notent que les modèles servis avec une latence plus faible et un débit plus élevé pourraient avoir un avantage structurel. Seuls Astra et Sol ont pensé à remplacer un ordre avant qu’il n’expire.
3. Le corps : apprendre comment réagit le véhicule
Le volant ne tourne pas instantanément, la voiture a un rayon de braquage limité, la caméra ne voit ni les côtés ni l’arrière. Les modèles devaient découvrir ces contraintes physiques en roulant. Cette idée d’« incarnation », ce que les chercheurs appellent l’IA physique, est exactement le défi que rencontrent aussi les robots humanoïdes.
| 💡 L’apprentissage « en contexte » Le résultat le plus intéressant n’est peut-être pas la victoire d’Astra, mais sa progression entre deux essais, sans aucun réentraînement. L’IA a tiré une leçon de son échec, l’a formulée par écrit, puis l’a appliquée. C’est ce qu’on appelle l’apprentissage en contexte : le modèle « apprend » uniquement grâce à ce qui est écrit plus haut dans la conversation. Exemple du quotidien : si vous dites à un assistant « non, je voulais un ton plus formel », il ajuste la suite sans qu’on modifie ses rouages internes. Ici, la même mécanique s’applique… à un volant. |
L’anecdote qui fait réfléchir : l’IA refusait de conduire
Avant même que la voiture ne bouge, un obstacle inattendu s’est dressé : Astra refusait parfois de prendre le volant, invoquant la sécurité et ce, malgré le parking vide, la vitesse bridée et le superviseur humain. Lui dire qu’il s’agissait d’une simulation ne marchait pas : les images trahissaient qu’il s’agissait d’une vraie voiture.
La solution ? Presque comique. Les ingénieurs ont renommé leur serveur MCP en « DrivingBench Sandbox » (« bac à sable » DrivingBench). Avec ce simple changement d’étiquette, le modèle a accepté de conduire de façon régulière.
| 🔴 Pourquoi ce détail n’est pas anodin D’un côté, on peut se réjouir qu’un modèle fasse preuve de prudence spontanée face à une action physique potentiellement dangereuse. De l’autre, cette prudence s’est évaporée à cause… d’un nom de fichier. Si un simple mot suffit à faire basculer la décision d’une IA, cela pose une vraie question sur la robustesse des garde-fous face à des contextes trompeurs. C’est un sujet que les spécialistes de la sécurité de l’IA regardent de très près. |
Combien coûte un trajet conduit par une IA ?
Chaque mot lu ou écrit par une IA se mesure en jetons (tokens), l’unité de facturation des fournisseurs. Et piloter une voiture, c’est très gourmand : il faut analyser des images en boucle.
| Indicateur | Valeur |
| Jetons consommés (tentative réussie d’Astra) | ≈ 6,6 millions |
| Coût de la tentative réussie (prix publics) | ≈ 7,74 $ |
| Coût cumulé des deux tentatives d’Astra | ≈ 9,75 $ |
| Coût ramené au kilomètre | ≈ 57 $ (≈ 92 $ par mile) |
| Vitesse moyenne | ≈ 1,5 km/h |
À titre de comparaison, faire rouler une Corolla thermique sur un kilomètre coûte quelques centimes d’euro en carburant. Conduire avec une IA généraliste revient donc des centaines de fois plus cher et à une vitesse de promeneur. Autant dire que personne ne remplacera son chauffeur VTC par ChatGPT demain matin.
Ce que ce test prouve… et ce qu’il ne prouve pas
Ce qu’il montre
- Un modèle généraliste, sans formation spécifique à la conduite, peut accomplir une tâche physique simple dans le monde réel.
- Les modèles savent tirer des leçons d’un échec au sein d’une même conversation.
- La perception spatiale et la réactivité restent les maillons faibles des IA actuelles.
Ce qu’il ne montre pas
- Que ces IA soient prêtes pour la route : pas de piétons, pas de feux, pas de circulation, pas de météo.
- Un classement définitif : chaque modèle n’a été évalué qu’une fois, et ses trois essais partageaient le même contexte, donc ils ne sont pas indépendants.
- Que les échecs soient purement imputables aux modèles : un bouton de démarrage d’openpilot retardait parfois le premier ordre de quelques secondes, et l’exemple de braquage fourni dans les consignes surestimait la durée d’un virage (60 secondes annoncées contre environ 25 en réalité).
Les concepteurs prévoient une version future avec plusieurs passages par modèle, différents niveaux de réflexion, davantage de modèles et un parcours plus long et plus difficile. Leur conclusion, prudente : les modèles de pointe peuvent désormais conduire un vrai véhicule à vitesse suffisamment faible, et cela justifie de redoubler d’efforts sur la sécurité et l’évaluation.
Faut-il s’émerveiller ou s’inquiéter ?
Voir une IA de discussion garer une Corolla à 1,5 km/h n’a rien d’une révolution pour la mobilité. Les systèmes spécialisés de Waymo transportent déjà des passagers dans plusieurs villes américaines, à vitesse normale, sans conducteur. Sur ce terrain précis, DrivingBench ne joue pas dans la même cour.
Mais l’intérêt est ailleurs. Ce test révèle que la frontière entre l’IA qui parle et l’IA qui agit devient poreuse. Le même modèle qui rédige votre compte rendu de réunion peut, avec trois outils et un boîtier à quelques centaines d’euros, actionner un engin d’une tonne. Aujourd’hui une voiture sur un parking ; demain un bras robotisé, un drone, un équipement industriel. Et l’épisode du « bac à sable » montre que les réflexes de prudence de ces modèles peuvent encore être contournés par une simple étiquette.
Notre position : c’est précisément parce que ce test est modeste qu’il est précieux. Mieux vaut découvrir les angles morts d’une IA sur un parking vide, avec un humain prêt à freiner, que sur une route départementale. Et le fait que tout soit publié en open source (code, consignes, vidéos) permet à n’importe quel chercheur de vérifier, critiquer et reproduire. C’est ainsi que la confiance se construit.
Source : DrivingBench