 Tech-Connect Actualités tech, tutoriels et astuces informatiques expliqués simplement
Le 6 octobre 2026, Google DeepMind a dévoilé EmbeddingGemma 2, un modèle ouvert conçu pour transformer du texte, du code, des images, des vidéos et des fichiers audio en représentations numériques comparables. Sa particularité est de placer ces différents contenus dans un même espace vectoriel de 768 dimensions.
Concrètement, cela signifie qu’une phrase, une photographie, un extrait sonore et une séquence vidéo peuvent être rapprochés les uns des autres selon leur signification. On peut alors rechercher une vidéo à partir d’une phrase, retrouver une image grâce à un fichier audio ou indexer une base documentaire directement sur un téléphone.
L’ambition est claire : rendre la recherche sémantique multimodale plus rapide, plus privée et moins dépendante des serveurs distants.
En résumé : EmbeddingGemma 2 n’est pas un chatbot qui rédige des réponses. C’est un modèle qui convertit des contenus en vecteurs afin de mesurer leur proximité sémantique.
Les embeddings expliqués simplement
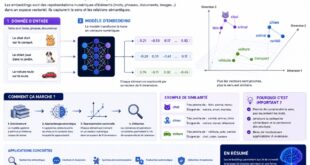
Un embedding, parfois traduit par « représentation vectorielle », est une longue liste de nombres qui résume le sens d’un contenu.
Imaginez une carte immense sur laquelle chaque document, chaque image ou chaque fichier audio serait placé à un endroit précis. Deux contenus proches par leur signification seraient positionnés à faible distance l’un de l’autre. À l’inverse, deux contenus sans rapport seraient éloignés.
Par exemple, les phrases suivantes pourraient produire des vecteurs relativement proches :
- « Le ciel est dégagé aujourd’hui. »
- « Il fait très beau dehors. »
En revanche, la phrase « Le train arrive en gare » serait probablement située plus loin, car elle renvoie à un autre contexte.
Cette technique est utilisée dans :
- la recherche sémantique ;
- les systèmes de recommandation ;
- le classement de documents ;
- la détection de contenus similaires ;
- le regroupement automatique de textes ;
- le RAG, ou génération augmentée par récupération ;
- la recherche de code dans une base logicielle.
La comparaison s’effectue souvent avec la similarité cosinus, une mesure qui évalue l’angle entre deux vecteurs. Plus l’angle est faible, plus les contenus sont considérés comme proches.
Ce qui change avec EmbeddingGemma 2
Avant l’arrivée de ce type de modèle, les développeurs utilisaient généralement un modèle pour chaque modalité :
- un modèle pour le texte ;
- un autre pour les images ;
- un système de transcription pour l’audio ;
- un encodeur vidéo pour les séquences animées.
Le problème était ensuite de faire dialoguer ces espaces vectoriels distincts. Un vecteur produit par un modèle de texte ne pouvait pas toujours être comparé directement à un vecteur issu d’un modèle d’image.
EmbeddingGemma 2 tente de résoudre ce cloisonnement en projetant le texte, le code, les images, la vidéo et l’audio dans un espace commun. Il devient alors possible d’effectuer des recherches croisées : texte vers image, texte vers vidéo, audio vers texte ou image vers image.
Exemple concret
Supposons qu’une personne possède plusieurs années de vidéos familiales sur son téléphone. Avec une indexation locale, elle pourrait taper :
« enfant qui souffle les bougies »
Le système ne chercherait pas uniquement les mots présents dans le nom du fichier. Il comparerait la requête avec les représentations vectorielles des images-clés extraites de chaque vidéo et retournerait les passages les plus proches.
Google présente déjà ce type d’usage avec son application Google AI Edge Gallery, qui permet de rechercher des images ou des moments vidéo à partir de requêtes en langage naturel, sans envoyer les fichiers vers un serveur distant.
Un modèle de 740 millions de paramètres, mais modulaire
EmbeddingGemma 2 contient environ 740 millions de paramètres. Ce nombre peut sembler important pour un téléphone, mais le modèle est conçu de manière modulaire.
Sa structure se répartit ainsi :
| Composant | Taille approximative |
|---|---|
| Partie texte et code | 270 millions de paramètres |
| Encodeur visuel | 170 millions |
| Encodeur audio | 300 millions |
| Ensemble complet | 740 millions |
Les encodeurs visuel et audio peuvent être chargés uniquement lorsque l’application en a besoin. Une application qui doit seulement indexer des documents textuels n’a donc pas intérêt à charger la totalité du modèle.
Les configurations possibles sont notamment :
- texte uniquement : environ 270 millions de paramètres ;
- texte et images : environ 440 millions ;
- texte et audio : environ 570 millions ;
- texte, images, vidéo et audio : environ 740 millions.
Cette architecture permet d’adapter le coût du modèle à l’usage réel. C’est une philosophie assez éloignée des modèles monolithiques qui chargent systématiquement toutes leurs briques, même lorsqu’une seule modalité est utilisée.
Pourquoi le modèle peut fonctionner sur un téléphone
Google indique qu’avec certaines optimisations et la quantification, EmbeddingGemma 2 utilise environ 191 Mo de mémoire vive active pour le texte seul et environ 567 Mo pour la version multimodale complète sur un Pixel 11 Pro.
Ces chiffres sont des mesures communiquées par Google dans un environnement précis. Ils ne doivent pas être interprétés comme une garantie valable pour tous les smartphones, car la consommation dépend du processeur, de la mémoire disponible, du format des poids, de la bibliothèque utilisée et du niveau de quantification.
L’intérêt du traitement local est néanmoins considérable :
- les données privées restent sur l’appareil ;
- la recherche peut fonctionner hors connexion ;
- la latence est réduite ;
- les coûts de serveur diminuent ;
- l’application dépend moins d’une API distante.
Pour une bibliothèque de photos personnelles, des enregistrements de réunions ou des documents professionnels sensibles, cette approche peut constituer un avantage décisif.
Une architecture compacte, mais techniquement sophistiquée
Selon la fiche officielle, la partie principale du modèle comporte :
- 24 couches ;
- une dimension interne de 512 ;
- une dimension cachée de 2 048 ;
- un vocabulaire de 262 144 tokens ;
- une fenêtre contextuelle glissante de 1 024 tokens ;
- une opération de moyenne des représentations avant projection ;
- une projection finale vers 768 dimensions.
Le modèle utilise également une combinaison d’attention locale et globale. Une grande partie du traitement peut se concentrer sur des fenêtres limitées, tandis que certaines couches conservent une vision plus large de la séquence. Cette stratégie permet de contenir les coûts de calcul lorsque les entrées deviennent longues.
Le vocabulaire de 262 144 tokens mérite une précision. Un token est une unité de texte, qui peut correspondre à un mot, à une partie de mot ou à un symbole. Plus le vocabulaire est vaste, plus le modèle peut représenter efficacement des langues, des noms propres et du code, mais plus la table de représentation occupe de mémoire.
On peut raisonnablement estimer qu’une part importante des paramètres de l’« embedder » est liée à cette table de tokens. Il s’agit toutefois d’une déduction à partir des chiffres publiés, et non d’une analyse officiellement détaillée par Google.
Une fenêtre commune de 8 192 tokens
Toutes les modalités partagent une fenêtre de contexte de 8 192 tokens. Cette enveloppe est répartie différemment selon le type de contenu.
| Modalité | Coût indicatif | Capacité maximale annoncée |
|---|---|---|
| Texte | 1 token par sous-mot | 8 192 tokens |
| Image | 280 tokens par image | Environ 29 images |
| Vidéo | 140 tokens par image-clé | Environ 58 images-clés |
| Audio | 25 tokens par seconde | Environ 327 secondes |
Ces valeurs sont des références par défaut. Une vidéo est généralement analysée à raison d’une image par seconde, mais cette fréquence peut être modifiée. Une image peut également recevoir un budget visuel plus ou moins important : augmenter ce budget améliore potentiellement la finesse de l’analyse, mais accroît la latence et la consommation de tokens.
Il faut également retenir que les modalités se partagent le même budget. Si l’on combine un long texte, plusieurs images et un fichier audio, chaque élément consomme une partie de la fenêtre disponible.
Cette contrainte est facile à comprendre avec un exemple : une requête contenant 20 images et deux minutes d’audio ne laissera pas autant de place au texte qu’une requête textuelle seule.
La représentation Matriochka : des vecteurs plus petits à la demande
EmbeddingGemma 2 utilise la méthode Matryoshka Representation Learning, ou MRL. Le nom fait référence aux poupées russes : une représentation plus petite est imbriquée dans une représentation plus grande.
Le vecteur complet possède 768 dimensions, mais il peut être réduit à :
- 512 dimensions ;
- 256 dimensions ;
- 128 dimensions.
L’objectif est de diminuer la taille des bases vectorielles et d’accélérer les recherches.
Prenons un million de vecteurs stockés en float32 :
- en 768 dimensions, il faut environ 3,1 Go, sans compter l’index ;
- en 256 dimensions, la taille tombe à environ 1 Go ;
- en 128 dimensions, elle descend à environ 0,5 Go.
La réduction à 128 dimensions est donc séduisante pour un appareil limité. Cependant, la perte de qualité est plus marquée dans les tâches multimodales. Google indique que la qualité reste relativement proche jusqu’à 256 dimensions, tandis que 128 dimensions sont plutôt adaptées aux usages textuels qui ont été soigneusement testés.
Une précaution essentielle
Après avoir tronqué un vecteur, il faut le normaliser à nouveau. Couper simplement un vecteur de 768 dimensions pour ne conserver que ses 128 premières valeurs peut dégrader silencieusement le classement.
Autre règle incontournable : les requêtes et les documents doivent avoir la même dimension. Une requête en 768 dimensions ne peut pas être comparée correctement à une base stockée en 128 dimensions.
Les performances : une progression surtout visible sur le code
Les évaluations publiées par Google donnent une image nuancée du modèle.
Sur le benchmark multilingue MTEB, EmbeddingGemma 2 obtient un score de 61,36, contre 61,15 pour la première version. Le progrès est donc limité sur le texte multilingue.
En revanche, la hausse est beaucoup plus importante sur le code : le score MTEB Code passe de 68,76 à 78,68, soit une amélioration de 9,92 points.
Les nouveaux résultats concernent également :
- les images ;
- les documents visuels ;
- la vidéo ;
- la recherche audio.
Ces capacités n’existaient pas dans EmbeddingGemma 1, qui était principalement un modèle d’embeddings textuels.
Il faut néanmoins conserver un regard critique. Ces résultats sont ceux publiés par Google à partir de ses propres évaluations. Ils montrent un potentiel important, mais ne constituent pas encore une preuve définitive de supériorité sur tous les modèles concurrents et tous les environnements.
Un modèle peut obtenir un excellent score général tout en étant moins performant sur un domaine particulier, comme le droit, la médecine, les documents administratifs ou une langue moins représentée dans les données d’entraînement.
Comment utiliser EmbeddingGemma 2 ?
La voie la plus simple passe par Python et la bibliothèque Sentence Transformers.
Installation
pip install -U sentence-transformers transformersPour les images, l’audio et la vidéo, il faut également installer les bibliothèques multimédias nécessaires :
pip install pillow soundfile torchcodecCes commandes correspondent aux indications de la documentation officielle.
Générer deux embeddings textuels
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

requete = "Comment fonctionne la recherche sémantique ?"
document = "La recherche sémantique compare le sens des requêtes et des documents."

vecteur_requete = model.encode(
    requete,
    prompt_name="SearchQuery"
)

vecteur_document = model.encode(
    document,
    prompt_name="Document"
)

score = model.similarity(vecteur_requete, vecteur_document)

print(score)
Le résultat est un score de similarité. Plus il est élevé, plus le document est susceptible de répondre à la requête.
Pourquoi les préfixes sont importants
EmbeddingGemma 2 utilise de courts préfixes adaptés à la tâche. Pour une recherche documentaire, une requête et un document ne doivent pas nécessairement être encodés de la même manière.
Exemples de préfixes intégrés :
SearchQuerypour une requête de recherche ;Documentpour un document ;QuestionAnsweringpour une question ;CodeRetrievalpour rechercher dans du code ;Classificationpour classer un contenu ;Clusteringpour regrouper des éléments ;SentenceSimilaritypour comparer deux phrases.
Oublier ces préfixes ne provoque pas forcément une erreur technique. Le programme fonctionne, mais la qualité du classement peut diminuer. C’est un piège discret, car l’application continue de produire des scores qui semblent parfaitement normaux.
Comparer un texte avec une image
EmbeddingGemma 2 peut également rapprocher une requête textuelle d’une image.
from sentence_transformers import SentenceTransformer

model = SentenceTransformer("google/embeddinggemma-2")

texte = model.encode(
    "un chien qui court dans un parc",
    prompt_name="SearchQuery"
)

image = model.encode({
    "image": "photo_parc.jpg"
})

score = model.similarity(texte, image)

print(score)
Dans un véritable moteur de recherche, on répéterait cette opération sur toutes les images préalablement indexées, puis on classerait les résultats selon leur similarité.
Le même principe peut servir à :
- trouver une photo à partir d’une description ;
- rechercher une scène précise dans une vidéo ;
- retrouver un enregistrement audio à partir d’une phrase ;
- associer des images de produits à des requêtes commerciales ;
- effectuer une recherche par exemple visuel.
Les principaux pièges à connaître
1. Ne pas utiliser float16
La documentation officielle indique que les activations d’EmbeddingGemma 2 sont incompatibles avec float16. Il faut privilégier bfloat16, lorsque le matériel le permet, ou float32.
Utiliser le mauvais format peut produire des valeurs NaN ou des embeddings silencieusement dégradés. Le système ne signalera pas nécessairement l’erreur de manière explicite.
2. Ne pas charger les encodeurs inutiles
Pour une recherche textuelle, il est inutile de charger les encodeurs audio et visuel.
model = SentenceTransformer(
    "google/embeddinggemma-2",
    config_kwargs={
        "vision_config": None,
        "audio_config": None
    }
)
Cette configuration réduit fortement l’empreinte mémoire et accélère le démarrage du modèle.
3. Réduire la dimension sans tester la qualité
Passer de 768 à 128 dimensions peut économiser beaucoup d’espace, mais la baisse de qualité peut être substantielle pour la vidéo, les images et l’audio.
La bonne méthode consiste à :
- créer un jeu de requêtes représentatif ;
- mesurer les résultats en 768 dimensions ;
- répéter le test en 512, 256 et 128 dimensions ;
- comparer la précision, la vitesse et la consommation mémoire ;
- choisir le meilleur compromis pour l’application.
4. Confondre embedding et réponse générée
EmbeddingGemma 2 ne rédige pas une réponse comme un grand modèle conversationnel. Il produit des vecteurs.
Dans une architecture RAG, il faut généralement l’associer à un modèle génératif :
- EmbeddingGemma 2 cherche les passages pertinents ;
- un modèle de langage lit ces passages ;
- le modèle génératif compose la réponse finale.
L’embedder constitue donc la boussole documentaire, tandis que le modèle génératif joue le rôle du rédacteur.
5. Négliger la sécurité applicative
EmbeddingGemma 2 est un modèle de représentation. Il ne bénéficie pas du même niveau de post-entraînement et de modération qu’un assistant conversationnel destiné au grand public.
Les développeurs doivent donc prévoir leurs propres mécanismes :
- filtrage des documents ;
- contrôle des données sensibles ;
- tests de biais ;
- restrictions d’accès ;
- validation des résultats ;
- conformité avec les politiques d’utilisation de Gemma.
Google précise que la responsabilité de ces protections incombe au développeur et à l’organisation qui déploie le système.
Quelles applications concrètes imaginer ?
Une recherche privée dans les photos
Un téléphone pourrait indexer localement les images personnelles et permettre des recherches comme :
- « vacances à la montagne » ;
- « chien dans la neige » ;
- « repas d’anniversaire » ;
- « coucher de soleil sur la plage ».
Un moteur de recherche pour les réunions
Un système local pourrait associer les notes, les transcriptions, les diapositives et les enregistrements audio d’une réunion. Une recherche comme « décision prise sur le budget marketing » pourrait renvoyer vers le passage audio, la note correspondante et la présentation concernée.
Une base de connaissances hors connexion
Dans un avion, un atelier isolé ou une zone où la connexion est instable, une application pourrait interroger une documentation technique stockée localement.
Une recherche intelligente dans le code
Avec l’amélioration annoncée sur MTEB Code, EmbeddingGemma 2 peut être intéressant pour indexer un projet logiciel. Un développeur pourrait rechercher :
« Où le système vérifie-t-il les droits d’accès d’un utilisateur ? »
Le moteur retournerait les fonctions et les fichiers qui traitent cette logique, même si le code n’utilise pas exactement les mêmes mots que la requête.
Un modèle pragmatique plutôt qu’une révolution spectaculaire
EmbeddingGemma 2 n’est pas forcément le modèle le plus impressionnant si l’on cherche un système capable de discuter, de raisonner longuement ou de produire des textes élaborés. Ce n’est pas son rôle.
Sa force réside ailleurs : dans la combinaison d’une empreinte relativement contenue, d’une architecture modulaire et d’un espace partagé entre plusieurs types de données.
Le modèle pourrait contribuer à rendre la recherche multimodale plus discrète et plus accessible. Jusqu’à présent, les applications intelligentes dépendaient souvent d’un aller-retour vers le cloud. Avec ce type d’embedder local, une partie du traitement peut se dérouler directement dans la poche de l’utilisateur.
La prudence reste toutefois nécessaire. Les performances annoncées proviennent principalement des évaluations de Google, les résultats peuvent varier selon les langues et les domaines, et la réduction à 128 dimensions risque de dégrader les usages multimodaux. Il faudra également vérifier la consommation énergétique réelle, la vitesse sur les appareils modestes et la qualité des résultats face à des bases de données volumineuses.
À mon avis, le véritable potentiel d’EmbeddingGemma 2 ne se trouve pas dans une démonstration spectaculaire, mais dans une multitude de petits usages quotidiens : chercher un souvenir dans une galerie, retrouver une phrase dans une réunion, naviguer dans un projet de code ou consulter une base documentaire sans connexion.
La question reste ouverte : préférez-vous une IA plus puissante hébergée dans le cloud, ou une IA légèrement moins ambitieuse mais capable de fonctionner localement, sans transmettre vos données ?
Source : Google DeepMind