 Tech-Connect Actualités tech, tutoriels et astuces informatiques expliqués simplement
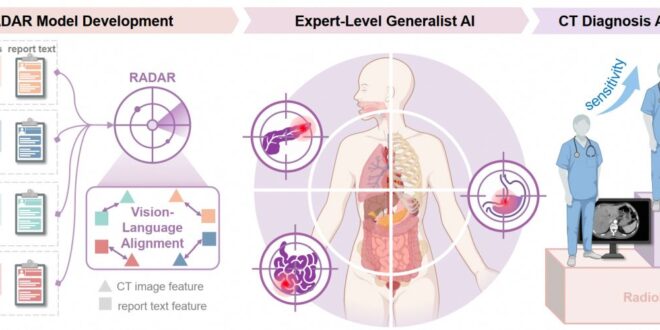
Imaginez un assistant qui parcourt un scanner du ventre, repère en une seule passe une tumeur, un foie gras ou une appendicite, et le fait mieux que la plupart des spécialistes. C’est, en substance, ce que revendique Radar, un modèle d’intelligence artificielle de l’Alibaba DAMO Academy, présenté dans la revue Science le 18 septembre 2026. Les titres claquent : « bat 23 radiologues sur 26 ». Alors, révolution médicale ou belle vitrine ? Décortiquons.
Radar, c’est quoi exactement ?
Radar est un modèle généraliste de lecture de scanners. Un scanner (ou tomodensitométrie, abrégé CT en anglais) est une pile d’images en coupes du corps. Celui de Radar se limite au scanner abdominal avec produit de contraste et vise 146 pathologies réparties sur 18 organes : tumeurs malignes, stéatose hépatique (le « foie gras »), appendicite aiguë, etc.
| Comment il a appris Plutôt que de faire annoter chaque image par des médecins (un travail colossal), l’équipe a fait apprendre au modèle à relier les images aux comptes rendus que les radiologues avaient déjà rédigés. Chaque organe du scanner est associé aux phrases qui le décrivent dans le rapport : c’est ce que les auteurs appellent l’alignement fin « organe par organe ». L’idée rappelle les modèles qui associent images et texte, adaptée ici à des volumes 3D. |
| Élément | Chiffre annoncé |
| Examens d’entraînement | environ 420 000 scanners abdominaux avec contraste, surtout issus de centres chinois (province du Zhejiang) |
| Paires image-texte | environ 15 millions |
| Test externe | huit centres cliniques indépendants, environ 40 000 examens réels |
| Pathologies / organes | 146 pathologies, 18 organes |
| Performance moyenne | AUC de 0,913 sur l’ensemble des constats |
L’AUC (aire sous la courbe) mesure la capacité à distinguer les cas malades des cas sains : 1 serait parfait, 0,5 équivaut à tirer à pile ou face. Au-dessus de 0,9, on parle généralement d’excellent résultat.
« Il bat 23 radiologues sur 26 » : ce que ça veut dire
L’équipe a comparé Radar à 26 radiologues de différents hôpitaux, de l’interne junior au médecin senior. La précision moyenne de l’IA dépasse celle de 23 d’entre eux. Ce n’est pas rien. Mais d’autres résultats, à notre sens plus parlants, concernent l’usage en binôme :
- Avec Radar en « deuxième lecteur », la sensibilité des radiologues (leur capacité à ne rien rater) augmente d’environ 10 points, selon l’une des sources, qui parle ailleurs d’une baisse d’environ 10 % des diagnostics manqués.
- Le temps de lecture baisse de plus de 30 %.
- Des radiologues juniors assistés atteindraient une précision comparable à celle de seniors travaillant sans aide.
Autrement dit, le scénario le plus crédible n’est pas « l’IA remplace le médecin », mais « le médecin travaille avec un second regard infatigable ».
Les questions que le titre ne règle pas
- Quelle mesure exactement (précision, sensibilité, AUC) a servi à déclarer l’IA « meilleure » ? Elles peuvent classer les lecteurs différemment.
- Que signifie « battre » : une différence statistiquement significative, ou simplement un score moyen plus élevé ? Et que valent les 3 radiologues restants ?
- L’étude est-elle rétrospective (sur des examens du passé) ou prospective (suivi de vrais patients) ? Les sources consultées ne le précisent pas.
- Une moyenne cache des écarts : 0,913 en moyenne, mais certaines pathologies rares peuvent être bien moins bien détectées.
Open source : oui, mais pas pour tout le monde
Alibaba a publié le code sur GitHub et Hugging Face sous licence Apache 2.0, très permissive. Les poids du modèle (le « cerveau » entraîné), eux, sont sous licence CC BY-NC-SA 4.0 : recherche autorisée, usage commercial interdit sans accord séparé. Pour un hôpital ou une start-up qui voudrait en faire un produit, la porte reste donc à négocier.
Pourquoi on ne l’utilisera pas demain à l’hôpital
| Les freins à connaître Radar est un outil de recherche, pas un dispositif médical autorisé. Selon la presse spécialisée, aucune autorisation de la FDA américaine n’existe, et le marquage CE européen demanderait un dossier à part. Les données d’entraînement viennent surtout de Chine : les performances sur d’autres populations ne sont pas démontrées, et aucun audit indépendant occidental n’a été publié. |
- Périmètre étroit : scanners abdominaux avec contraste uniquement. Ni poumons, ni cerveau, ni enfants, ni scanners sans contraste.
- Équipements : le modèle demande une puissance de calcul importante pour fonctionner en local, et sa documentation est jeune.
- Confidentialité : faire tourner le modèle chez soi évite d’envoyer des données de patients à l’étranger, mais certains observateurs rappellent que les lois chinoises s’appliquent à l’éditeur.
- Preuves cliniques : un essai clinique est référencé (NCT07040358), mais aucun résultat prospectif n’a été publié à notre connaissance.
Rappelons un principe de base : un bon score sur des archives n’est pas un bénéfice prouvé pour les patients. Il faut des essais qui mesurent la santé réelle, pas seulement la performance de lecture.
Et pour nous, simples patients ?
Retenez surtout la direction prise : l’IA médicale passe du « petit modèle qui cherche un seul cancer » au généraliste qui balaie des dizaines de maladies d’un coup. À terme, cela pourrait accélérer les diagnostics et soulager des radiologues débordés. Mais entre l’article scientifique et le cabinet de votre ville, il y a des années d’évaluation, d’autorisations et de remboursement. Si vous passez un scanner, c’est toujours un médecin qui vous rend le diagnostic.
Cet article est informatif et ne remplace pas un avis médical.