« 2,1 billions de paramètres », a claironné Elon Musk à propos de Grok 4.7. Impressionnant, non ? Sauf que ce chiffre, attribué à Musk par la presse, ne figure pas dans l’annonce officielle de xAI, qui ne dit même pas si le modèle est « dense » ou « Mixture of Experts » (MoE). Chez Anthropic, c’est pareil pour Claude Fable 5.1 : la société ne publie ni le nombre de paramètres ni la configuration des couches.
Autrement dit, quand on compare ces géants, on compare des étiquettes que personne ne peut vérifier. Raison de plus pour comprendre ce que ces étiquettes veulent dire, et pourquoi deux modèles de même taille peuvent se comporter comme le jour et la nuit. C’est l’objet de cet article, et je promets de ne pas vous noyer.
Le modèle dense : tout le monde travaille, tout le temps
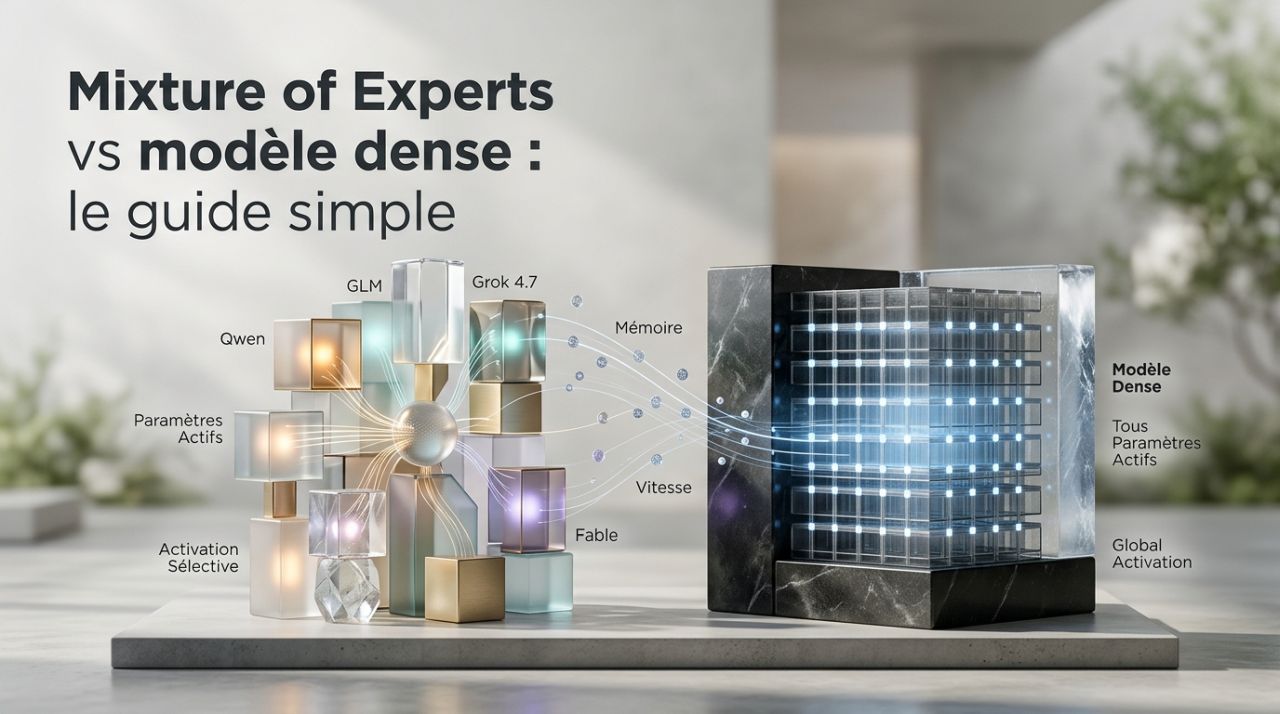
Dans un modèle dense, chaque mot que l’IA lit ou écrit traverse la totalité des paramètres. Aucun passe-droit : tous les boutons sont sollicités pour chaque token (rappel : un token, c’est un morceau de mot). C’est simple, c’est régulier, et ça demande une puissance de calcul proportionnelle à la taille du modèle.
L’image que je vous propose : une petite bibliothèque de quartier tenue par un seul bibliothécaire qui connaît tout. Quelle que soit votre question, c’est lui qui répond. Il est compétent sur tous les sujets, mais il doit réfléchir à chaque fois avec l’intégralité de ses connaissances.
Le Mixture of Experts : un aiguilleur et des spécialistes
Dans un modèle MoE (mélange d’experts), on remplace certaines parties du réseau par plusieurs sous-réseaux spécialisés : les « experts ». Devant eux, un petit mécanisme, le routeur, regarde chaque token et décide à quels experts le confier. En général, seuls deux ou quelques experts sont réveillés sur des dizaines.
Reprenons notre bibliothèque, version médiathèque : 64 spécialistes (cuisine, droit, informatique, jardinage…) et, à l’entrée, une borne d’accueil qui vous oriente vers les deux plus pertinents. La médiathèque connaît énormément de choses, mais pour votre question, seuls deux employés se déplacent.
Paramètres totaux : tout ce que le modèle « possède » (la taille du fichier).
Paramètres actifs : ce qui travaille réellement pour un token donné (la facture de calcul). Exemple concret : Mixtral 8x7B (Mistral AI, décembre 2023) a 46,7 milliards de paramètres au total, 8 experts, et chaque token n’en visite que 2. Chez un modèle dense, ces deux chiffres sont identiques ; chez un MoE, ils peuvent être très éloignés.
Pour la petite histoire, l’idée n’a rien de neuf : elle date de 1991 (Jacobs, Jordan, Nowlan et Hinton, « Adaptive Mixtures of Local Experts »). Elle est restée en sommeil, puis a explosé avec les versions « éparses » (sparse) conçues chez Google Brain, où l’on n’active qu’une poignée d’experts par token.
Le duel en conditions réelles : Qwen 3.6 27B contre 35B-A3B
Rarement l’occasion de comparer un dense et un MoE de la même famille. Alibaba nous la donne avec Qwen 3.6 : un modèle dense de 27 milliards de paramètres, et un MoE de 35 milliards au total dont environ 3 milliards actifs par token (c’est le « A3B » du nom). Voici les chiffres relevés par un comparatif spécialisé :
| Qwen 3.6 27B (dense) | Qwen 3.6 35B-A3B (MoE) | |
|---|---|---|
| Paramètres actifs par token | 27 milliards | ≈ 3 milliards |
| Mémoire en 4 bits | ≈ 16 Go | ≈ 21 Go |
| Vitesse (RTX 4090, 4 bits) | 25 à 35 tokens/s | 80 à 120 tokens/s |
| SWE-bench Verified (correction de bugs) | 77,2 % | 73,4 % |
| Terminal-Bench (tâches en terminal) | 59,3 % | 48,2 % |
Les deux leçons à retenir sont contre-intuitives :
- Le MoE est 3 à 4 fois plus rapide, car il ne fait travailler que 3 milliards de paramètres à chaque mot.
- Mais il est plus gourmand en mémoire (21 Go contre 16 Go) : même si seuls quelques experts travaillent, tous doivent être chargés, parce qu’on ne sait jamais d’avance lesquels le routeur choisira. En somme, on paie la place, pas la vitesse.
- Le dense reste en tête sur les tâches difficiles (jusqu’à 11 points d’écart sur Terminal-Bench). Le MoE est « le meilleur choix par défaut » pour un assistant réactif, selon ce comparatif, tandis que le dense convient aux gros chantiers où l’on veut la précision maximale.
Pourquoi tous les géants ne font pas du MoE
Si le MoE est plus rapide, pourquoi ne pas l’adopter partout ? Parce qu’il a ses propres casse-têtes :
- L’équilibrage de charge : certains experts reçoivent tout le monde, d’autres ne servent à rien. Les équipes ajoutent des pénalités pour les forcer à travailler équitablement. DeepSeek a même inventé des experts « partagés » (qui gèrent les bases, comme la grammaire) et une méthode d’équilibrage sans pénalité supplémentaire.
- Les « tokens perdus » : quand trop de tokens veulent le même expert dans un même lot, certains sont laissés de côté.
- Une formation plus capricieuse : l’entraînement d’un MoE peut être instable, et les résultats varient avec de nombreux choix de conception.
- L’appétit en mémoire : voir plus haut. Pour un serveur d’entreprise, ce n’est pas rédhibitoire ; pour votre PC, ça peut l’être.
Alors, Grok 4.7 et Fable 5.1 : dense ou MoE ?
Le titre de cet article vous promettait ce duel. Voici la réponse honnête : personne ne le sait, du moins pas publiquement.
| Grok 4.7 (xAI) | Claude Fable 5.1 (Anthropic) | |
|---|---|---|
| Paramètres totaux | 2,1 billions, cité par Musk et repris par la presse, absent de l’annonce officielle | Non publiés par Anthropic |
| Dense ou MoE ? | Non précisé par xAI | Non précisé par Anthropic |
| Prix API (par million de tokens) | 2 $ en entrée / 6 $ en sortie | 10 $ en entrée / 50 $ en sortie |
Tentant de conclure : « Grok est huit fois moins cher, donc c’est un MoE ». Je vous déconseille ce raccourci. Un prix dépend de la marge visée, du matériel, de la stratégie commerciale, du taux de remplissage des serveurs. Il ne trahit pas l’architecture. Quand on lit une affirmation du type « ce modèle est un MoE de X experts », sans source officielle, il s’agit d’une hypothèse.
Fable 5.1 et Grok 4.7 sont des modèles propriétaires dont l’architecture interne n’est pas documentée. À l’inverse, on connaît la forme des modèles à poids ouverts, comme GLM-5.2 (MoE, environ 40 milliards de paramètres actifs sur plus de 740 milliards au total) : n’importe qui peut en ouvrir le fichier et vérifier.
Dense ou MoE : lequel choisir pour votre usage ?
| Votre situation | Plutôt dense | Plutôt MoE |
|---|---|---|
| PC avec peu de mémoire | ✅ Moins de mémoire à taille égale | ⚠️ Il faut tout charger |
| Assistant réactif (chat, autocomplétion) | Plus lent | ✅ 3 à 4 fois plus rapide |
| Tâches complexes et précision maximale | ✅ Souvent devant | Écart possible sur les tâches dures |
| Serveur avec beaucoup de mémoire | Coûteux en calcul | ✅ Très rentable |
Pour tester vous-même, Ollama permet de comparer en quelques minutes. Et pour ajuster la mémoire, notre guide sur la quantization vous explique comment « arrondir » un modèle pour qu’il tienne sur votre PC.
1. Les laboratoires devraient-ils être obligés de publier l’architecture et la taille de leurs modèles ? Ou est-ce un secret industriel légitime ?
2. Sur votre PC, préférez-vous un modèle plus rapide (MoE) ou un peu plus précis (dense) ?
3. Avez-vous remarqué une différence de comportement entre deux modèles de taille comparable ?