


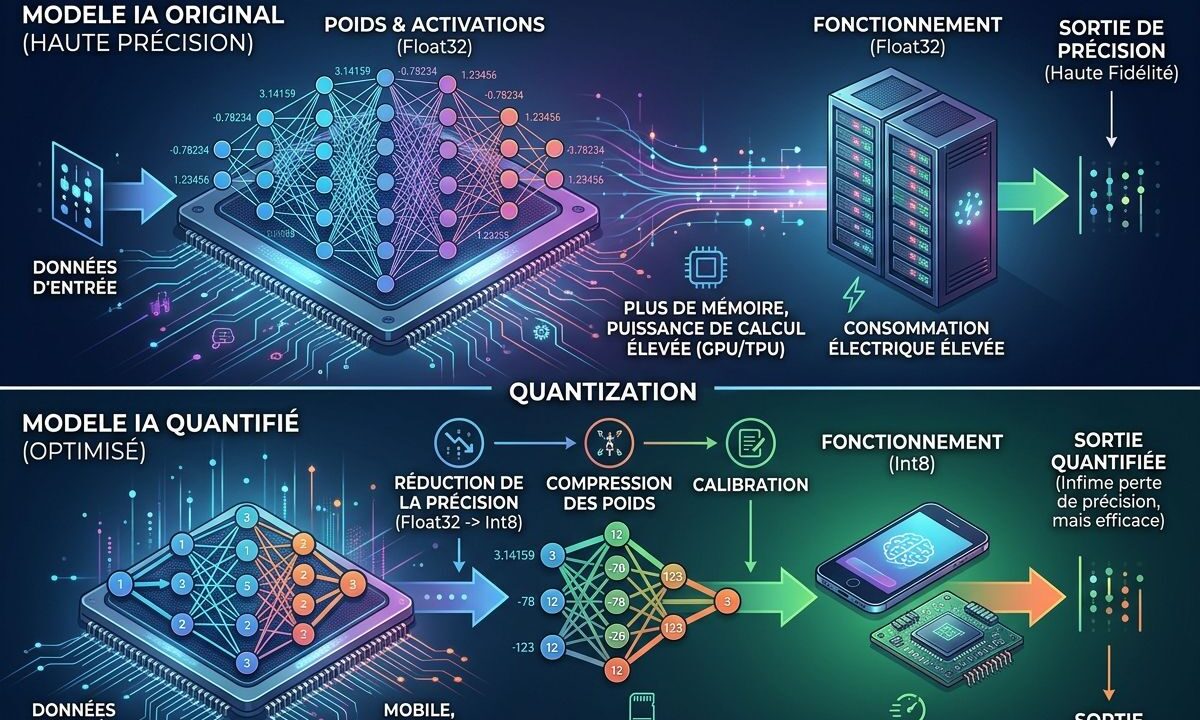
Un test indépendant publié fin août 2026 par le laboratoire Quesma a fait grand bruit dans les communautés d’IA locale : en testant le modèle Qwen3.8-27B d’Alibaba à plusieurs niveaux de compression, les chercheurs ont montré que la version en 4-bit tient parfaitement la comparaison avec le modèle complet, mais que la version en 1-bit, censée faire encore plus de place sur votre disque dur, s’effondre littéralement, au point de générer des réponses proches du hasard. Ce mot un peu barbare, « quantization » ou « quantification » en français, mérite qu’on s’y attarde, parce qu’il conditionne directement votre capacité à faire tourner une intelligence artificielle puissante sur votre propre ordinateur, sans dépendre d’un service en ligne payant.
Pourquoi un modèle d’IA est-il si lourd au départ ?
Un modèle de langage, une fois entraîné, se résume à une immense collection de nombres, appelés « poids » (ou paramètres). Chacun de ces nombres encode une petite fraction de ce que le modèle a appris, la probabilité qu’un mot en suive un autre, la relation entre deux concepts, etc. Un modèle de plusieurs dizaines de milliards de paramètres, c’est donc littéralement des dizaines de milliards de nombres à stocker, chacun occupant de la mémoire. Plus la précision de chaque nombre est fine, plus le modèle est lourd mais aussi, en théorie, plus il est capable de nuances.
Un paramètre (ou poids) est un nombre ajusté automatiquement pendant l’entraînement d’un modèle d’IA, qui détermine l’importance d’une connexion entre deux éléments du réseau de neurones artificiel. Plus un modèle a de paramètres, plus il peut théoriquement représenter des relations complexes mais plus il demande de mémoire et de puissance de calcul pour fonctionner.
La quantification : arrondir intelligemment
La technique de compression la plus répandue s’appelle la quantification. L’idée est simple à saisir avec une image : imaginez que vous deviez noter le prix de chaque article dans un magasin. Vous pourriez indiquer 4,278451 euros avec une précision extrême, ou simplement arrondir à 4,30 euros. Dans l’immense majorité des cas, cet arrondi ne change rien à la décision d’achat du client mais il est bien plus rapide à lire et à traiter mentalement. La quantification fait exactement ça avec les poids d’un modèle d’IA : au lieu de les stocker avec une précision de 16 ou 32 bits (le format habituel, très fin), on les arrondit à des formats bien plus compacts : 8 bits, 4 bits, voire, dans le cas extrême de Bonsai-2, seulement 3 valeurs possibles par poids (-1, 0 et +1), ce qu’on appelle la quantification ternaire.
Concrètement, un modèle stocké en pleine précision (on parle de BF16, pour « brain floating point 16 bits ») peut peser plusieurs dizaines de gigaoctets. Une fois quantizé en 4 bits, ce même modèle peut tenir en un tiers, voire un quart de cet espace, ce qui fait toute la différence entre « impossible à faire tourner chez soi » et « fonctionne sur un ordinateur grand public équipé d’une bonne carte graphique ».
Pourquoi ça ne devrait pas marcher… et pourquoi ça marche quand même
Intuitivement, on pourrait s’attendre à ce que réduire aussi drastiquement la précision d’un modèle le rende beaucoup moins performant. C’est en partie vrai : il existe toujours une perte de qualité, aussi minime soit-elle. Mais les réseaux de neurones ont une particularité étonnante : ils sont globalement tolérants au bruit, c’est-à-dire capables de continuer à fonctionner correctement même quand on introduit de petites imprécisions dans leurs calculs internes. C’est un peu comme reconnaître un visage familier sur une photo légèrement floue : les détails fins manquent, mais l’information essentielle reste largement suffisante pour l’identifier.
Une astuce technique appelée « mise à l’échelle par groupes » (group-wise scaling) permet de limiter les dégâts de la quantification : plutôt que d’arrondir tous les poids du modèle de la même façon, on découpe le modèle en petits blocs, et chaque bloc conserve son propre facteur d’ajustement pour compenser au mieux la perte de précision locale. C’est cette technique, notamment, qui permet à Bonsai-2 de revendiquer 98,2 % des performances de son modèle d’origine malgré une compression supérieure à 9 fois.
Le test qui a tout changé : 4-bit contre 1-bit
Sorti le 14 août 2026 par l’équipe Qwen d’Alibaba, sous licence libre Apache 2.0, Qwen3.8-27B est un modèle « dense » (c’est-à-dire que la totalité de ses 27 milliards de paramètres est utilisée pour chaque réponse, contrairement aux modèles dits « à mélange d’experts » qui n’en activent qu’une partie). C’est justement sa taille, suffisamment grande pour être puissante, suffisamment raisonnable pour tenir sur du matériel grand public, qui en a fait un candidat idéal pour tester différents niveaux de quantization.
Le laboratoire Quesma a dépensé environ 3 000 dollars en location de cartes graphiques professionnelles (NVIDIA L40S, H100, H200) pour comparer cinq versions du même modèle sur des tests de référence reconnus dans le secteur (GPQA Diamond pour le raisonnement scientifique, IFBench pour le respect des instructions, et Terminal-Bench 2.1 pour la programmation en autonomie) :
| Niveau de précision | Taille du fichier | Résultat observé |
| BF16 (pleine précision) | ≈ 54 Go | Référence de départ |
| 8-bit (Q8_0) | ≈ 29 Go | Quasi identique à la pleine précision |
| 4-bit (Q4_K_M) | ≈ 17 Go | Aucune différence notable sur les benchmarks testés |
| 2-bit (UD-Q2_K_XL) | ≈ 10,7 Go | Baisse de performance visible, mais reste globalement fonctionnel |
| 1-bit (UD-IQ1_S) | ≈ 6,2 Go | Effondrement : scores proches du hasard sur le raisonnement |
Le résultat le plus frappant concerne la version en 1-bit : sur le test GPQA Diamond, qui évalue le raisonnement scientifique de niveau doctorat, ses scores tombent au niveau d’une réponse aléatoire, dans certains cas, même en dessous. Pire : demander au modèle de « réfléchir plus longtemps » (un réglage courant pour améliorer la qualité des réponses) aggrave encore le problème, le modèle épuisant son budget de réflexion sans jamais produire de réponse exploitable.
La différence n’est pas linéaire. Passer de 16 bits à 4 bits élimine surtout de la redondance : le modèle conserve l’essentiel de sa capacité à distinguer des nuances entre les concepts qu’il a appris. Mais en dessous d’un certain seuil autour de 2 bits, et très nettement à 1 bit, on ne retire plus seulement de la redondance : on détruit une partie de la structure même qui permet au modèle de raisonner. C’est un peu comme retirer des mots redondants dans une phrase (ça reste compréhensible), puis continuer à en retirer jusqu’à ne garder qu’un mot sur cinq (la phrase devient incompréhensible). Il existe un point de rupture, pas une dégradation progressive et douce.
Ce que ça change concrètement si vous voulez faire tourner une IA chez vous
Cette leçon dépasse largement Qwen3.8-27B : elle s’applique à la quasi-totalité des modèles de langage que l’on peut télécharger et faire tourner soi-même, via des outils comme Ollama ou LM Studio.
- La version 4-bit d’un modèle est presque toujours le meilleur compromis entre qualité et taille de fichier, c’est la référence à privilégier par défaut, sauf contrainte de mémoire très sévère.
- La version 8-bit n’apporte, dans la plupart des cas, qu’un gain de qualité marginal par rapport au 4-bit, pour un espace disque et une mémoire vidéo nettement plus importants.
- La version 2-bit peut dépanner sur du matériel limité, mais avec une perte de qualité perceptible, en particulier sur des tâches complexes comme la programmation autonome.
- La version 1-bit, malgré des chiffres de compression impressionnants sur le papier, n’est généralement pas exploitable pour un usage sérieux, méfiez-vous des annonces qui mettent en avant uniquement le gain d’espace disque, sans mentionner l’impact sur la qualité des réponses.
À titre indicatif, une version 4-bit de Qwen3.8-27B (environ 17 Go) tient confortablement sur une carte graphique grand public de 24 Go de mémoire vidéo, comme une NVIDIA RTX 3090 ou 4090, ou sur un Mac équipé d’une puce Apple Silicon de milieu de gamme sans jamais avoir besoin d’envoyer la moindre donnée vers un serveur distant.
Le test de Quesma a utilisé des quantizations produites par Unsloth, une équipe reconnue pour la qualité de son travail de compression. Deux fichiers portant la même étiquette (« 4-bit », « Q4 ») peuvent en réalité donner des résultats différents selon la méthode et le soin apportés par celui qui les a produits. Avant de télécharger un modèle quantizé, il est donc utile de vérifier la réputation de la source, plutôt que de se fier uniquement au nombre de bits affiché.
D’autres techniques de compression existent aussi
La quantification n’est pas la seule méthode utilisée par les laboratoires d’IA pour alléger leurs modèles. On retrouve régulièrement deux autres grandes familles de techniques dans l’actualité :
- L’élagage (pruning) : cette méthode consiste à identifier et supprimer purement et simplement les connexions les moins utiles du réseau de neurones, un peu comme on taillerait les branches mortes d’un arbre pour ne garder que l’essentiel de sa structure.
- La distillation de connaissances (knowledge distillation) : dans ce cas, on entraîne un petit modèle (« l’élève ») à imiter le comportement d’un grand modèle déjà performant (« le professeur »), en lui faisant reproduire ses réponses plutôt qu’en le formant depuis zéro sur les données brutes originales.
Cette course à la compression n’est pas qu’un exercice de style académique. Elle conditionne directement votre capacité à faire tourner une IA performante sur votre propre matériel, sans dépendre d’un abonnement cloud ni envoyer vos données vers un serveur distant. Un modèle compressé intelligemment peut tourner sur un ordinateur portable classique, voire sur un smartphone récent, là où sa version non compressée exigerait une carte graphique professionnelle hors de prix.