


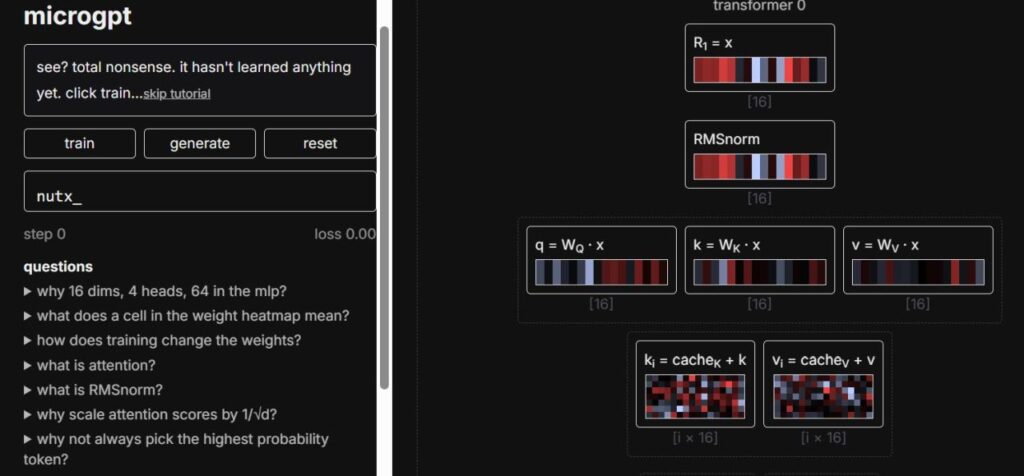
On parle beaucoup des GPT en termes de résultats, ce qu’ils répondent, ce qu’ils génèrent, mais rarement de ce qui se passe réellement à l’intérieur, pendant qu’ils calculent. Un projet sobrement baptisé microgpt, change la donne : il permet de regarder, en direct et sans installer quoi que ce soit, un authentique modèle de type GPT s’entraîner et réfléchir, chiffre par chiffre, sous vos yeux, directement dans votre navigateur.
Un GPT minuscule, mais un vrai GPT
Le projet s’inspire directement des travaux pédagogiques d’Andrej Karpathy, l’une des figures les plus reconnues du milieu de l’intelligence artificielle pour sa capacité à rendre accessibles des concepts techniques complexes. Le modèle proposé par défaut ne compte que 4 000 paramètres, une taille dérisoire comparée aux centaines de milliards de paramètres des modèles commerciaux comme GPT ou Qwen, et sa tâche est volontairement simple : apprendre à générer des prénoms prononçables, lettre après lettre, à partir d’exemples.
| 💡 À SAVOIR Un paramètre, dans un modèle d’intelligence artificielle, est une valeur numérique ajustée automatiquement pendant l’entraînement pour que le modèle produise de meilleures prédictions. Plus un modèle a de paramètres, plus il peut, en théorie, capturer des relations complexes dans les données, mais aussi plus il devient coûteux à faire fonctionner. Avec seulement 4 000 paramètres, microgpt reste volontairement à l’échelle d’un exercice pédagogique, loin des modèles de production. |
Ce qu’on voit vraiment défiler à l’écran
Contrairement à un simple schéma statique expliquant le fonctionnement d’un transformeur, microgpt affiche les calculs qui se produisent réellement pendant l’entraînement et l’inférence du modèle. Concrètement, l’interface permet de :
- Observer les activations circuler entre les différentes couches du réseau de neurones, en temps réel, pendant que le modèle traite une séquence de caractères.
- Cliquer sur n’importe quel élément affiché (une matrice, une connexion, un bloc) pour obtenir une explication contextuelle de son rôle.
- Ajuster la profondeur du réseau (le nombre de couches) et observer immédiatement l’effet de ce changement sur la qualité des prédictions.
- Suivre la baisse progressive de la fonction de perte (loss), l’indicateur numérique qui mesure à quel point les prédictions du modèle s’améliorent au fil de l’entraînement.
Le détail technique qui simplifie tout : des lettres, pas des mots
À la différence des GPT commerciaux, qui découpent le texte en unités appelées tokens (souvent des fragments de mots), microgpt fonctionne à l’échelle du caractère : chaque lettre de l’alphabet anglais constitue une unité distincte, soit 26 tokens possibles au total. Ce choix pédagogique simplifie énormément la compréhension du mécanisme sous-jacent, sans pour autant trahir le principe de fonctionnement d’un vrai GPT : à chaque étape, le modèle tente simplement de prédire le caractère suivant le plus probable, compte tenu de ceux qui précèdent.
| Indicateur | Valeur observée |
| Perte de départ (modèle non entraîné) | ≈ 3,3 (équivalent à un tirage au hasard parmi 27 symboles) |
| Perte après entraînement | ≈ 2,37 |
| Rendements décroissants | Au-delà d’environ 1 000 étapes d’entraînement |
| Levier le plus efficace ensuite | Augmenter le nombre de couches plutôt que le nombre d’étapes |
📝 NOTE : Le chiffre de 3,3 pour la perte de départ n’est pas anodin : avec 27 symboles possibles (les 26 lettres plus un caractère de fin), un modèle qui devine totalement au hasard obtiendrait statistiquement une perte logarithmique proche de cette valeur. Voir ce nombre descendre à mesure que l’entraînement progresse est une façon très concrète de visualiser un modèle qui « apprend » réellement, plutôt que de simplement l’affirmer sur la foi d’un graphique abstrait.
Les limites, assumées par l’exercice lui-même
Plusieurs commentateurs ont rapidement souligné une évidence : un modèle de 4 000 paramètres ne peut, par nature, servir à grand-chose d’utile au sens pratique du terme. Un utilisateur a ainsi rapporté avoir entraîné le modèle pendant 12 000 étapes sans jamais obtenir de véritables prénoms cohérents en sortie, l’outil se contentant surtout de mémoriser des fragments de ses données d’exemple plutôt que de généraliser un vrai apprentissage. D’autres ont noté des ralentissements sensibles sur mobile, en particulier sous Android, ainsi qu’un site supposant parfois un niveau de connaissance préalable en apprentissage automatique un peu élevé pour un public totalement débutant.
| ⚠️ ATTENTION Le créateur du site a lui-même reconnu une simplification volontaire : les visualisations de matrices sont plafonnées à 16 dimensions affichées à l’écran, même lorsque les dimensions réelles du modèle sont supérieures, uniquement pour garder l’interface lisible. C’est un choix pédagogique assumé, mais qui signifie que ce que vous voyez à l’écran n’est jamais tout à fait, au pixel près, l’intégralité de ce qui se calcule en coulisses. |
Pourquoi ça vaut quand même le détour
- Vous avez toujours trouvé les explications sur les transformeurs trop abstraites, avec des schémas figés qu’il faut imaginer en mouvement : ici, tout bouge réellement sous vos yeux.
- Vous voulez comprendre concrètement ce que signifie « entraîner » un modèle, au-delà du mot valise qu’on entend partout : regarder une courbe de perte descendre en direct rend la notion nettement plus tangible.
- Vous cherchez un point de départ pour initier un public non technique (élèves, collègues, famille) aux bases du fonctionnement d’une IA générative, sans installation logicielle.
On en débat ?
- Ce genre de visualisation en direct vous aide-t-il vraiment à mieux comprendre le fonctionnement d’un GPT, ou reste-t-il trop technique pour un public non initié ?
- Pensez-vous que les grands éditeurs d’IA (OpenAI, Google, Anthropic) devraient proposer ce type d’outil pédagogique ouvert sur leurs propres modèles, ne serait-ce qu’à échelle réduite ?
- La simplification volontaire de l’outil (caractères plutôt que tokens, matrices plafonnées à 16 dimensions) vous semble-t-elle un compromis acceptable pour la pédagogie ?
- Avez-vous déjà utilisé un outil similaire (comme le LLM Visualizer de Brendan Bycroft) pour comprendre le fonctionnement interne d’un modèle de langage ?
Source : Andrej Karpathy – microgpt